动手学习深度学习(部分章节)的笔记
1.基础概念
Section titled “1.基础概念”数学里的维数和 PyTorch 张量的维数是不同的东西
数学上, a = (1,2) 有两个分量,称为二维向量,进行矩阵计算时可以把它写成行向量或列向量;
而 PyTorch 中的向量维数,指的是有几条轴,也就是需要几个索引才能定位一个数:(已取2为例)
| 张量写法 | 形状 shape | 索引示例 | 含义 |
|---|---|---|---|
[1, 2] | (2,) | a[1] | 一条轴,两个元素,没有行列方向 |
[[1, 2]] | (1, 2) | a[0, 1] | 两条轴,1 行 2 列 |
[[1], [2]] | (2, 1) | a[1, 0] | 两条轴,2 行 1 列 |
- 为什么tensor可以做下标 PyTorch支持用整数张量作为索引,一次选取多个位置,这叫作“高级索引”,并且支持调整顺序,重复选择。
3.线性神经网络
Section titled “3.线性神经网络”3.1.线性回归
Section titled “3.1.线性回归”回归 是能为一个或多个自变量与因变量之间关系建模的一类方法。 经常用来表示输入和输出之间的关系
3.1.1.基本元素
Section titled “3.1.1.基本元素”- 训练数据集
- 样本
- 标签/目标
- 特征/协变量
3.1.1.1.线性模型
Section titled “3.1.1.1.线性模型”线性假设是指目标可以表示为特征的加权和,如以下式子:
其中, 和 称为权重, 权重决定特征对预测值的影响. 称为偏置(bias)、偏移量(offset)、截距(intercept).
偏置是指当所有特征都为 0 时, 预测值应该为多少.
本式是输入特征的一个 仿射变换(affine transformation)
仿射变换的特点是通过加权和对特征进行线性变换
给定一个数据集,我们的目标是寻找模型的权重和偏置。
在机器学习领域,通常采用高维数据集,故采用线性代数表示法。
当我们输入包含 d 个特征时,我们将预测结果 表示为:
将所有特征放入向量 中,并将所有权重放到向量 中,我们可以用点积以简洁表示模型:
在(3.1.3)中,向量 x 对应于单个数据样本的特征,用符号表示的矩阵
3.1.1.4.随机梯度下降
Section titled “3.1.1.4.随机梯度下降”- 梯度下降:这种方法几乎可以优化所有深度学习模型,它通过不断的在损失函数递减的方向上更新参数来降低误差。
梯度下降最简单的方法是计算损失函数(数据集中所有样本的损失均值)关于模型参数的导数。
由于每次更新参数后要重新遍历整个数据集,导致执行相当慢,因此我们通常采用随机抽取一小批样本,这种变体叫做小批量随机梯度下降。
- 表示每个小批量中的样本数,也称为批量大小
- 表示学习率
批量大小和学习率的值通常是手动预先预定,而不是通过模型训练得到,这些可以调整但不在训练过程中更新的参数称为超参数(hyperparameter)。
调参是选择超参数的过程。超参数通常是我们根据训练迭代结果来调整的,而训练迭代记过是在独立的验证数据集上评估得到的
3.1.1.5.用模型进行预测
Section titled “3.1.1.5.用模型进行预测”给定“已学习”的线性回归模型 ,现在我们可以按给定特征估计目标。
这一过程我们称为预测 (prediction)
3.1.2.矢量化加速
Section titled “3.1.2.矢量化加速”在训练小批量样本时,我们希望同时进行处理,因此我们对计算进行矢量化,从而利用线性代数库
%matplotlib inlineimport mathimport numpy as npimport torchfrom d2l import torch as d2l由于在本书中我们将频繁进行运行时间基准测试,故定义一个计时器
class Timer:    def _init_(self):        self.times = []        self.start()
    def start(self):        self.tik = time.time()
    def stop(self):        self.times.append(time.time() - self.tik)        return self.time[-1]
    def avg(self):        return sum(self.times) / len(self.times)
    def sum(self):        return sum(self.times)
    def cumsum(self):        return np.array(self.times).cumsum().tolist()
3.1.3.正态分布与平方损失
Section titled “3.1.3.正态分布与平方损失”3.2.从零开始实现线性回归
Section titled “3.2.从零开始实现线性回归”3.2.1.生成数据集
Section titled “3.2.1.生成数据集”def synthetic_data(w, b, num_examples): #@save """生成y=Xw+b+噪声""" X = torch.normal(0, 1, (num_examples, len(w))) y = torch.matmul(X, w) + b y += torch.normal(0, 0.01, y.shape) return X, y.reshape((-1, 1))
true_w = torch.tensor([2, -3.4])true_b = 4.2features, labels = synthetic_data(true_w, true_b, 1000)3.2.2.读取数据集
Section titled “3.2.2.读取数据集”def data_iter(batch_size, features, labels): num_examples = len(features) indices = list(range(num_examples)) # 这些样本是随机读取的,没有特定的顺序 random.shuffle(indices) for i in range(0, num_examples, batch_size): batch_indices = torch.tensor( indices[i: min(i + batch_size, num_examples)]) yield features[batch_indices], labels[batch_indices]3.2.3.初始化模型参数
Section titled “3.2.3.初始化模型参数”不妨从均值为0、标准差为0.01的正态分布中采样随机数来初始化权重,并将偏置初始化为0
w = torch.normal(0,0.01,size = (2,1), requires_grad = True)b = torch.zeros(1,requires_grad = True)3.2.4.定义模型
Section titled “3.2.4.定义模型”def linreg(X,w,b): return torch.matmul(X, w) + b3.2.5.定义损失函数
Section titled “3.2.5.定义损失函数”def squared_loss(y_hat, y): return (y_hat - y.reshape(y_hat.shape)) ** 2 /2这里的 y 是张量类,形状通常是(batch_size, 1) 平方后差值按位平方
3.2.6.定义优化算法
Section titled “3.2.6.定义优化算法”def sgd(params,ls,batch_size): with torch.no_grad(): for param in params: param -= lr * param.grad / batch_size param.grad.zero_()3.2.7.训练
Section titled “3.2.7.训练”lr = 0.03//学习率num_epochs = 3//训练迭代周期net = linregloss = square_loss
for epoch in range(num_epochs): for X, y in data_iter(batch_size, features, labels): l = loss(net(X, w, b) y) l.sum().backward() sgd([w, b], lr, batch_size) with torch.no_grad(): train_l = loss(net(features, w, b),labels) print(f'epoch{epoch + 1}, loss{float(train_l.mean()):f}')3.3.softmax回归的一些problem
Section titled “3.3.softmax回归的一些problem”这时 函数, 如果 中有一些数值非常大, 那么 可能
因此, 我们有一个解决的技巧: 在计算前先从所有 中减去 , 由推断可知这并不影响 的返回值
在减法和规范化步骤之后, 可能有些 具有加法负值, 求指数后有接近 0 的值,即下溢(underflow).
因此, 我们的解决方法是, 将 和交叉熵结合, 避免反向传播过程中可能出现的数值稳定性问题. 故有
4.多层感知机
Section titled “4.多层感知机”4.1.多层感知机
Section titled “4.1.多层感知机”4.1.1.隐藏层
Section titled “4.1.1.隐藏层”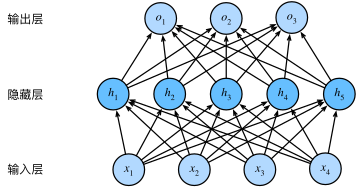
4.1.2.激活函数
Section titled “4.1.2.激活函数”4.1.2.1.ReLU函数
Section titled “4.1.2.1.ReLU函数”修正线性单元(Rectified linear unit, ReLU), 提供了一种简单的非线性变换, 即保留正元素丢弃负元素.
使用原因, 梯度表现好(负数为 0 , 正数为 1 )
变体很多, 如 pReLU , 此变体为 ReLU 添加了一个线性项, 因此参数即使是负的, 某些信息仍然可以通过:
4.1.2.2.sigmoid函数
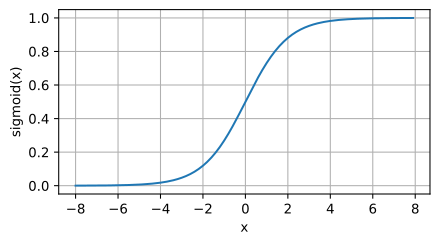
Section titled “4.1.2.2.sigmoid函数”sigmoid 函数将输入变换为区间(0,1)上的输出, 因此被称为挤压函数(squashing function)
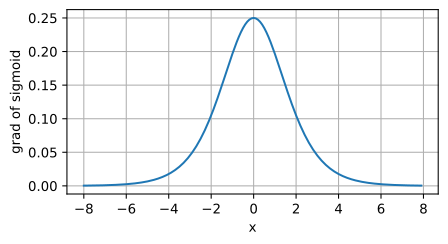
梯度
4.1.2.3.tanh函数
Section titled “4.1.2.3.tanh函数”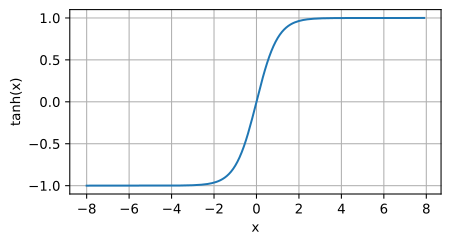
梯度
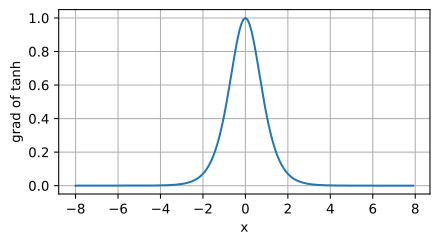
4.4.模型选择、欠拟合和过拟合
Section titled “4.4.模型选择、欠拟合和过拟合”作为机器学习研究者,我们的目标是发现 模式(pattern)。 但是我们如何确定模型拥有的是泛化的能力,而不是单单拥有了“记忆力”?这就需要让模型判断从未见过的样本。
如何发现可以泛化的模式是机器学习的根本问题
当我们训练模型时,我们只能访问数据中的小部分样本。在大型系统中,当我们使用有限的样本是,可能会发现:当收集更多数据时,之前找到的明显关系并不成立。
将模型在训练数据上拟合的比在潜在分布中更接近的现象称作 过拟合(overfitting),因此我们使用一种对抗过拟合的技术,即正则化(regularization)
4.4.1.训练误差和泛化误差
Section titled “4.4.1.训练误差和泛化误差”训练误差指模型在训练数据集上计算得到的误差。
泛化误差指模型应用在同样从原始样本的分布中抽取的无限多数据样本时,模型误差的期望。
4.4.1.1.统计学习理论
Section titled “4.4.1.1.统计学习理论”我们假设训练数据和测试数据都是从相同的分布中独立提取的,这叫做独立同分布假设,
4.4.1.2.模型复杂性
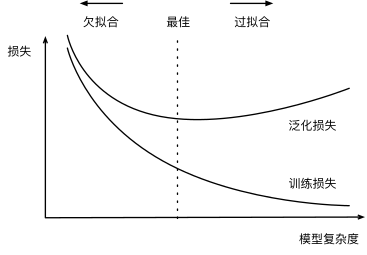
Section titled “4.4.1.2.模型复杂性”当我们有简单的模型和大量的数据时,我们期望泛化误差与训练误差相近。当我们有更复杂的模型和更少的样本时,我们预计训练误差会下降但泛化误差会增大。
通常,我们认为需要更多训练迭代的模型比较复杂,需要早停(early stopping)的模型较为简单.
为了给出一些直观的印象,我们介绍几个倾向于影响模型泛化的因素。
- 可调整参数的数量。当可调整参数的数量很大时,模型往往更容易过拟合。
- 参数采用的值。当权中重的取值范围较大时,模型可能更容易过拟合。
- 训练样本的数量。即使模型简单,也很容易过拟合只包含一两个样本的参数。而过拟合一个由数百万个样本的数据集则需要一个极其灵活的模型。
4.4.2.模型选择
Section titled “4.4.2.模型选择”在机器学习中,我们通常在评估几个候选模型后选择最终的模型,这个过程叫做模型选择。为了确定最佳模型,我们采用验证集
4.4.2.1.验证集
Section titled “4.4.2.1.验证集”由于lack of 数据,常见做法时将数据分为三份,处理训练和测试数据集以外,增加一个验证数据集。但是验证数据和测试数据之间的边界极其模糊,本书除非特殊说明,否则使用的实际上是训练数据和验证数据的数据集,没有早知道测试数据集。
4.4.2.2.K折交叉验证
Section titled “4.4.2.2.K折交叉验证”由于缺少数据,流行解决方案是采用K折交叉验证,将原始数据分为K个不重叠子集。执行K次模型训练和验证,每次在 K-1 个子集上训练,剩余一个子集用于验证。
4.4.3.欠拟合还是过拟合
Section titled “4.4.3.欠拟合还是过拟合”如果模型不能降低训练误差,这可能意味着模型过于简单了,无法捕捉模式,此外由于寻来你和验证误差之间的泛化误差很小,我们有理由相信用一个更复杂的模型降低训练误差,这种现象被称为 欠拟合。
如果训练误差明显低于验证误差时表明严重的过拟合,不过这并不总是一件坏事。
4.4.3.1.模型复杂性
Section titled “4.4.3.1.模型复杂性”高阶多项式函数比低阶复杂得多,高阶多项式的参数较多,模型函数的选择范围较广,因此,在固定训练数据集的情况下,高阶多项式函数相对于低阶多项式函数的训练误差应该始终更低。
事实上,当数据样本包含了 x 的不同值时,函数阶数等于数据样本数量的多项式函数可以完美拟合数据集。
4.4.3.2.数据集大小
Section titled “4.4.3.2.数据集大小”一般来说,数据越多越好
4.5.权重衰减
Section titled “4.5.权重衰减”假设我们拥有尽可能多的高质量数据,我们便可以将重点放在正则化技术上。
*权重衰减(weight decay)*是最广泛是用的正则化技术之一,它通常也被称为 L2 正则化,这项技术通过函数与 0 的距离来衡量函数的复杂的度,应为在所有函数 中,函数 在某种意义上是最简单的,但是我们应该如何精确的测量一个函数和 0 之间的距离呢?没有一个正确的答案。
我们的损失函数是
为了防止过拟合,即当 w 过大时,轻微的样本变化就会导致输出的巨大偏差,因此我们考虑将 w 的某个范数作为惩罚项加到最小化损失中,